この記事で分かること
TSMCの3D DRAM製造参入検討
最大顧客であるNVIDIAなどの強い要請を受け、TSMCが3D DRAM(メモリセルを垂直方向に立体積層する次世代メモリ)の自社生産に向けた検討を開始したと報じられています。
これまでTSMCは、HBM(High Bandwidth Memory)において「ロジックダイ(制御用の土台部分)」の製造や高度な先端パッケージング(CoWoS等)を担ってきましたが、今回の検討が実現すればメモリの記憶セルそのものの製造へと領域を広げることになります。
3D DRAMとは何か
3D DRAMとは、従来の平面的(2D)に配置されていたDRAM(Dynamic Random-Access Memory)のメモリセルを、垂直方向(3D)に立体積層・統合する次世代のメモリ技術です。
NANDフラッシュメモリが「3D NAND」へと移行したことで大容量化を成し遂げたのと同様に、物理的な微細化の限界に直面しているDRAMにおいても、立体化による飛躍的な大容量化、高速化、省電力化を狙って開発が進められています。
1. なぜ「3D DRAM」が必要なのか
従来の2D DRAMは、1つのトランジスタと1つのキャパシタ(コンデンサ)のペア(1T1C)をシリコン基板上に平面的に並べることで構成されてきました。
しかし、半導体の微細化が進むにつれて以下の深刻な限界に直面しています。
- キャパシタ容量の維持の困難さ: DRAMは電荷をキャパシタに蓄えることで「0」や「1」を記憶します。微細化して面積が小さくなると、キャパシタの物理的な体積が減り、蓄えられる電荷量(容量)が低下します。これにより、データが勝手に消失する「ソフトエラー」やリフレッシュ(再充電)頻度の増加(消費電力増)を引き起こします。
- 寄生容量とクロストーク: セル同士の距離が極めて近くなるため、配線間の寄生容量や電気的干渉(クロストーク)が増大し、信号の伝送速度や信頼性が低下します。
こうした物理的・電気的限界を突破するための抜本的な解決策として、セルを平面的に並べるのではなく垂直方向に積み上げる3D構造が必要とされています。
2. 3D DRAMの主なアプローチ(構造上の分類)
3D DRAMの実現に向けては、主に以下の2つのアプローチが研究・開発されています。
① モノリシック3D DRAM(Monolithic 3D)
- 仕組み: 単一のシリコン基板上で、プロセスを重ねながらトランジスタとキャパシタの層を垂直に何層も作り込む方式。
- 特徴: NANDフラッシュの3D化(BiCS Flashなど)に近いアプローチです。層間を結ぶ配線の密度を極めて高くできるため、理想的な超高密度化が可能ですが、下層のデバイスが高温プロセスにさらされるため、トランジスタの電気的特性が劣化するなどの激しい製造上の困難(熱バジェットの問題)があります。
② ヘテロジニアス / ハイブリッドボンディング方式(Stacked / Hybrid Bonding)
- 仕組み: ロジック回路(制御用ダイ)とメモリセルアレイダイを別々に製造し、最先端のハイブリッドボンディング(銅同士の直接接合)技術を使って垂直に貼り合わせる方式。
- 特徴: 現在、TSMCなどのファウンドリやメモリメーカーがHBMや次世代メモリの拡張として現実的なアプローチとして注力している手法です。製造プロセスの異なる回路を最適に組み合わせることができるため、歩留まりの面で有利とされています。
3. 実現に向けた主な技術的課題
- 新材料・新構造の導入: 従来のキャパシタ構造のままでは垂直積層が難しいため、キャパシタを不要にする「キャパシタレスDRAM(Gain Cell等)」や、高誘電率(High-k)絶縁膜、酸化物半導体(OSトランジスタ)などの新材料・新構造の研究が進められています。
- コストと歩留まり: 製造プロセスが極めて複雑化するため、NANDのように商業ベースで「安価に大量生産」できる歩留まりを達成するには高い技術的ハードルが存在します。
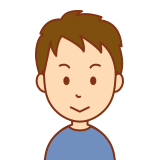
3D DRAMとは、従来の平面的だったDRAMのメモリセルを垂直方向に立体積層する次世代メモリ技術です。微細化の限界を突破し、AI向けなどに飛躍的な大容量化と高速化を実現します。
なぜ従来のキャパシタ構造のままでは垂直積層が難しいのか
従来のDRAMが採用している「キャパシタ(コンデンサ)構造」のままでは垂直積層(3D化)が極めて難しい理由は、物理的・化学的、そして電気的な複数の限界が複合しているためです。
1. アスペクト比(縦横比)の限界と構造の崩壊
- 現状: 従来のDRAMでは、微小なセル面積でも十分な電荷量を確保するため、キャパシタを極細かつ非常に高い「シリンダー型」や「ピラー型(柱状)」(高いアスペクト比)に加工しています。
- 課題: これを垂直方向に何層も積み上げようとすると、高さ方向の寸法がさらに制約され、製造時のエッチングや成膜の精度が出なくなるだけでなく、構造物が自重や洗浄液の表面張力で物理的に倒壊・密着(コラプス現象)してしまいます。面積を縮小しつつ容量を維持するという物理法則のトレードオフが、立体化によってさらに深刻化します。
2. 熱バジェット(製造プロセスの温度耐性)の制約
- 現状: モノリシック(単一基板上で下層から順に積み上げる)方式で3D化する場合、下層のデバイスを形成した後に、上層の形成やアニール(熱処理)のために高熱プロセスを加える必要があります。
- 課題: 従来の高性能なキャパシタに使われる高誘電率(High-k)絶縁膜や特殊な金属電極は、高温にさらされると結晶化の変質や酸化、原子の拡散を起こし、絶縁破壊や容量抜けを引き起こしてしまいます。つまり、下層の性能を維持したまま上層を焼き付けることが化学的に困難です。
3. トランジスタのリーク電流とデータ保持特性の悪化
- 現状: DRAMは「キャパシタに蓄えた電荷がどれだけ漏れないか(リフレッシュ特性)」が命です。
- 課題: 多層化プロセスにおける熱ストレスは、スイッチングを担うシリコン(Si)トランジスタの結晶構造に欠陥を生じさせます。これによりリーク電流(オフ電流)が急増し、電荷が瞬く間に放電されてしまうため、DRAMとしての記憶保持機能が維持できなくなります。これが、次世代3D DRAMにおいて従来のシリコンに代わる「酸化物半導体(OS)トランジスタ」の研究が必須とされる理由です。
4. 配線(ルーティング)の複雑化と寄生容量
- 課題: 3D NANDフラッシュは、多数のメモリセルを垂直方向に「直列」に串刺しにする構造(ストリング構造)が使えます。しかし、DRAMは個々のセルを独立して高速に読み書き(ランダムアクセス)する必要があるため、立体的に配置された無数のセルに対して個別にワード線やビット線を引き回さなければなりません。
- この配線経路が複雑化しすぎると、配線間の寄生容量や抵抗が爆発的に増大し、3D化した最大のメリットであるはずの「高速性」や「省電力性」が相殺されてしまいます。
こうした理由から、従来の延長線上にあるキャパシタ構造のまま3D化することは極めて困難であり、業界では「キャパシタ自体をなくす(キャパシタレスDRAM)」新しいメモリセル構造や、全く異なる新材料の導入を模索しています。
従来のキャパシタは微細で高アスペクト比のため立体化で倒壊しやすく、製造時の熱で性能が劣化するほか、リーク電流の増大や複雑すぎる配線により、DRAMとしての高速・安定動作が維持できなくなるためです。
なぜTSMCはメモリーの製造を行うのか
TSMCが本来の事業分野である「ロジック半導体の製造受託(ファウンドリ)」を超えて、メモリ(3D DRAM)セル自体の製造を検討し始めた理由は、主に以下の3つの背景によるものです。
1. 最大顧客(NVIDIA等)からの強い要請とメモリ不足
生成AIの爆発的普及に伴い、AIチップに必須となる高帯域・大容量メモリの供給不足と価格急騰が続いています。主要顧客であるNVIDIAやAppleなどにとって、メモリの調達難やコスト高はボトルネックとなっています。
そのため、NVIDIA側からTSMCに対して「新たなDRAM供給源となって供給量を確保してほしい」という強い働きかけがあったことが直接的な契機とされています。
2. メモリとロジックの境界の曖昧化(HBM4等の技術進化)
次世代AI向けメモリ(HBM4以降)では、メモリを統合・制御する「ベースダイ(土台部分)」をTSMCなどの最先端ロジックプロセス(3nm/5nm等)で製造する流れが加速しています。
さらに、ロジックとメモリを垂直に接合する「3D積層技術(SoICやハイブリッドボンディング)」の領域では、TSMCが世界最高水準の技術力を持っています。DRAMセル自体の生産に参入することで、ロジックとメモリを完璧に密結合させた超高性能チップを自社で一括提供できるようになります。
3. 三大メモリメーカーの寡占回避とサプライチェーンの主導権
現在、DRAM市場はSamsung、SKハイニックス、Micronの3社が実質的に寡占しています。NVIDIAなどのファブレス企業としては、TSMCがメモリ製造を担うことで供給元の選択肢を増やし、価格交渉力を高めたいという狙いがあります。
TSMCにとっても、AIアクセラレータの「計算コア(GPU/NPU)」だけでなく「メモリ領域」まで自社のサプライチェーンに取り込むことで、AIインフラ市場における支配的なポジションをさらに強めることができます。
主要顧客であるNVIDIA等からAI向けメモリ不足解消への強い要請を受けたためです。最先端3D積層技術を活かして記憶セルも自社で一括生産し、既存3大メーカーの寡占回避とAI供給網の主導権確保を狙っています。
コメント