この記事で分かること
DeepSeekの新AIモデル
DeepSeekが発表した「DeepSeek-V4.1-Flash-1017」は、軽量なアクティブパラメータ数でありながらフロンティアモデル(最高峰モデル)に匹敵する性能を持つとして、AI業界で大きな注目を集めています。
総パラメータ数は大規模(MoE構成)ですが、実際にトークンを処理・生成する際のアクティブパラメータ数は入力時80億、出力時160億と非常にスリムに抑えられています点が主な特徴です。
DeepSeek-V4.1-Flash-1017の特徴は何か
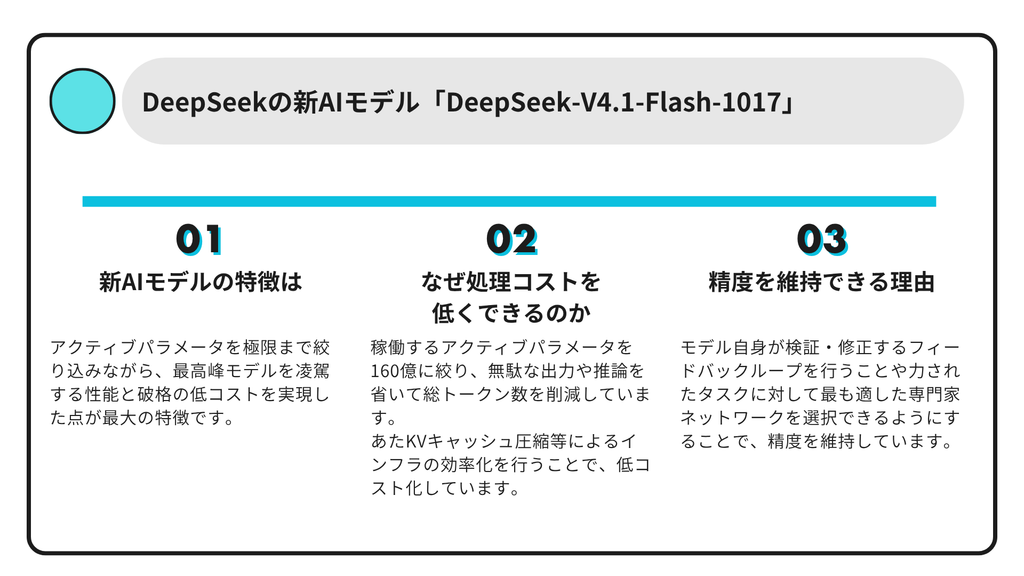
2026年10月17日に中国のDeepSeekが発表した新世代モデル「DeepSeek-V4.1-Flash-1017」は、アクティブパラメータを極限まで絞り込みながら、フロンティアモデル(最高峰モデル)を凌駕する性能と破格の低コストを実現した点が最大の特徴です。
1. 非対称型アクティブパラメータと新アーキテクチャ
- 高いパラメータ効率: バックボーンの総パラメータ数は552B(5,520億)のMoE構造ですが、推論時に動くアクティブパラメータはPrefill(入力)時 8B / Decode(出力)時 16Bと非常に軽量に設計されています。
- 非対称CED構造: 20層のCausal Encoder(8B活性)と20層のCausal Decoder(16B活性)を組み合わせた構成を採用し、モデル応答の高速化を図っています。
- Engram(条件付きメモリ): 本体とは別枠で196Bの条件付きメモリ「Engram」を組み込んでおり、メモリ効率を高めつつ長期的な文脈維持を実現しています。
2. コード・エージェント型タスクでのトップ性能
- 最上位モデルを凌駕: ソフトウェア開発エージェント向けベンチマーク「DeepSWE v1.1」においてスコア 77.0 を記録し、Anthropicの「Claude Opus 5」(スコア 74.0)を上回りました。
- 競技プログラミング実績: Codeforcesにてレーティング 3471 を記録するなど、コーディングや自動化タスク(Automation-Bench等)においてトップクラスの完走力・解法能力を示しています。
- 自己フィードバック強化学習(RLSF):内部信頼度や自律生成した批評を報酬信号として学習させるRLSF(Reinforcement Learning with Self-Feedback)を導入し、複雑な複数ステップのタスク実行力を大幅に高めています。
3. 米国勢の10分の1以下の「単一タスクコスト」
- 無駄な思考・トークンの削減: 精度を維持しながら冗長な推論や長い出力を自動的に省く設計になっており、タスク完了に必要な総トークン数自体を大きく削減しています。
- 圧倒的な低価格API: 難関タスク1問あたりの処理コストが、タスク単位コストで米国競合モデルの10分の1以下を達成しています。
- KVキャッシュ圧縮: CSA2(Causal Sparse Attention 2)などの技術によりグローバルKVキャッシュを従来比25%に圧縮し、メモリ消費を大幅に節約しています。
4. 開発者フレンドリーなオープン仕様
- MITライセンスで無償公開: Hugging FaceおよびModelScope上でオープンウェイト版が提供されており、商用利用・改変・セルフホストが自由に可能です。
- 長文脈&マルチモーダル対応: 入力はテキストと画像に対応し、最大100万トークン(1M tokens)のコンテキスト長をサポートしています。
- 思考レベルの微調整: API経由の利用時、思考モードの強度(
reasoning_effort)を 1〜100 の範囲で細かく調整可能です。
軽量なインフラ基盤で動作しつつ高難度のエージェント処理を低コストでこなせるため、自動化ワークフローやプログラミング補助の分野で急速に導入が進められています。
DeepSeek-V4.1-Flash-1017は、160億のアクティブパラメータという軽量さでありながら、冗長な出力を防ぐ設計によりコストを削減し、コードやエージェント性能で「Claude Opus 5」等を上回るオープンモデルです。
なぜ処理コストを低くできるのか
DeepSeek-V4.1-Flash-1017が圧倒的な低コスト(米国勢の10分の1以下)を実現している主な理由は、計算資源の消費を抑える独自のアーキテクチャと無駄なトークンを削る最適化の組み合わせによるものです。
1. アクティブパラメータの極小化(MoE構造)
- バックボーンの総パラメータ数は大きいものの、実際にトークンを処理・生成する際に稼働するアクティブパラメータ数(出力時16B)を極限まで絞り込んでいます。
- これにより、1トークンあたりの演算量(計算負荷)が物理的に小さくなり、サーバーの電力やGPUリソースの消費を大幅に抑えられています。
2. 無駄な出力を防ぐ「パレート改善」(トークンの削減)
- 従来のAIで見られがちな冗長な思考プロセスや長すぎる説明文を、精度の落とさない範囲で自動的に抑制しています。
- 「タスク完了に必要な総トークン数」そのものを最小化しているため、APIの課金基準となる消費トークン量を劇的に減らすことが可能です。
3. 高度なKVキャッシュ圧縮技術
- 「Causal Sparse Attention 2」などの最適化技術を導入し、推論時にメモリを大量消費するKVキャッシュを効率的に圧縮しています。
- メモリ帯域のボトルネックを解消することで、ハードウェアの稼働効率を高め、インフラストラクチャのコストを下げています。
4. 独自のハードウェア・分散処理最適化
- 大規模なMixture-of-Experts(MoE)モデルを効率よく動かすための独自の通信・並列化技術を蓄積しており、サーバー群の稼働コスト自体を極限まで削ることに成功しています。
「動かす規模を小さくし、無駄な言葉を出さず、メモリを効率よく使う」という徹底した省力化設計が、破格の低コストを支えています。成といった「最終的な成果(アウトカム)」を厳しく評価する強化学習を行っています。
稼働するアクティブパラメータを160億に絞り、冗長な出力や推論を省いて総トークン数を削減。さらにKVキャッシュ圧縮等によるインフラの効率化で低コストを実現しています。
どのように精度を下げないようにしているのか
DeepSeek-V4.1-Flash-1017が、出力を削りながらも最高峰モデルに匹敵する(あるいは上回る)精度を維持できているのは、単に「手抜き」をしているのではなく、効率と品質を両立させる高度な学習・設計手法を取り入れているためです。
1. 自己フィードバック強化学習(RLSF)
- 単に答えを出すだけでなく、モデル自身が「自分の思考プロセスや出力に矛盾がないか」「本当にタスクを完遂できているか」を検証・修正するフィードバックループを行っています。
- これにより、無駄な長文や迷走(ハルシネーション)を省きながら、要点が凝縮された高精度なアウトプットを自律的に生成できるようになります。
2. 高精度なMoE(Mixture-of-Experts)ルーティング
- 稼働するアクティブパラメータは160億と軽量ですが、入力されたタスクに対して「最も適した専門家ネットワーク(エキスパート)」を高精度かつダイナミックに選択・活性化しています。
- 「全体を漫然と重く動かす」のではなく、「必要な部分ピンポイントで最高峰の頭脳を働かせる」仕組みになっているため、処理量を抑えても専門性の高い判断が可能です。
3. 条件付きメモリ「Engram」による文脈補完
- モデル本体のパラメータを肥大化させる代わりに、別枠で用意された高効率なメモリ機構(Engram)を活用しています。
- これにより、複雑なコードの文脈や長期的なプロセスの記憶を正確に保持できるため、軽量なモデルにありがちな「途中での失念や論理の破綻」を防いでいます。
4. 厳格な「結果重視」の報酬設計
冗長な言葉を出さずに「最短手数で正しい答えにたどり着く」ことが高得点につながる報酬体系になっているため、効率化と精度の向上が同時に達成されています。
ベンチマークでの完走率や正しいコード生成といった「最終的な成果(アウトカム)」を厳しく評価する強化学習を行っています。
自己フィードバック強化学習で迷走や冗長性を排除し、高精度なMoEルーティングと条件付きメモリの活用により、軽量でありながら高い推論力と文脈維持力を維持しています。
コメント