この記事で分かること
SMICの好調決算
中国の半導体受託生産(ファウンドリー)最大手、中芯国際集成電路製造(SMIC)が2026年11月12日に発表した2026年7〜9月期(第3四半期)決算では、純利益が前年同期比123.4%増(約2.2倍)の4億2,840万ドルとなり、売上高も四半期として過去最高を更新しました。
世界的な半導体需給の逼迫(半導体不足)と中国国内での半導体国産化シフトが重なり、国内顧客からの受注が急拡大したことが最大の要因となり、過去最高の売り上げ高となっています。
SMICはどんな半導体を製造しているのか
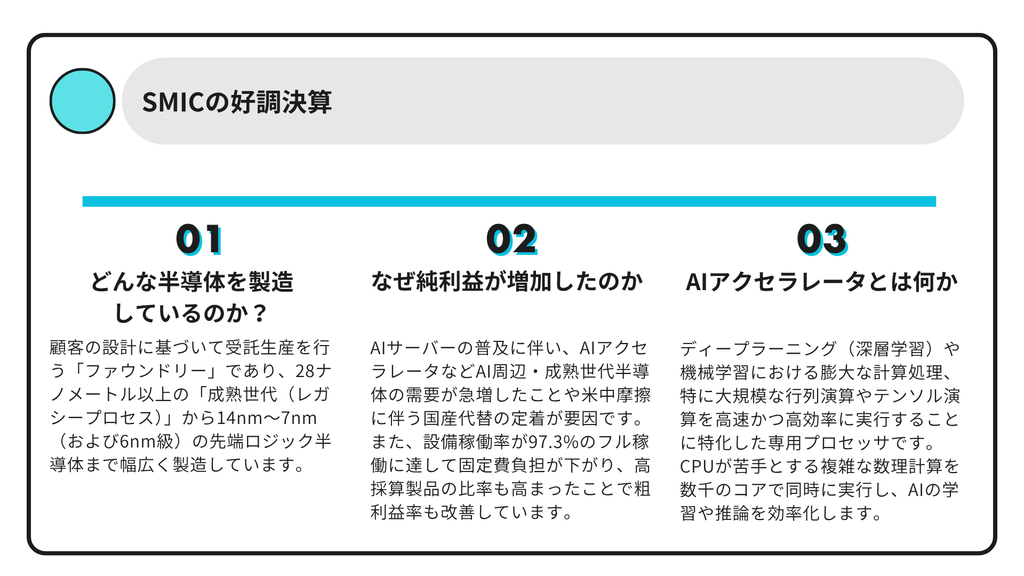
SMIC(中芯国際)は顧客の設計に基づいて受託生産を行う「ピュアプレイ・ファウンドリー」であり、28ナノメートル(nm)以上の「成熟世代(レガシープロセス)」と特殊プロセスを収益の柱としつつ、14nm〜7nm(および6nm級)の先端ロジック半導体まで幅広く製造しています。
1. 主力領域:成熟世代・特殊プロセス(28nm〜350nm)
SMICの売上高やウエハー出荷枚数の大半を占め、今回の2026年7〜9月期決算でフル稼働(97.3%)の原動力となった中核領域です。
- 電源管理IC(PMIC)・アナログ半導体
- プロセス技術: BCD(バイポーラ・CMOS・DMOS混載プロセス)など。
- 用途:スマートフォン、PC、サーバー、EV(電気自動車)の電力制御・電圧変換。AIサーバーの普及に伴い1台あたりの搭載数が増えており、世界的に供給が逼迫している分野です。
- マイコン(MCU)・組み込み不揮発性メモリ
- プロセス技術: 28nm〜180nmのロジックおよびeFlash(混載フラッシュメモリ)、SONOSなど。
- 用途:自動車のボディ制御・車載インフォテインメント、白物家電、産業用ロボット、スマートメーター。
- イメージセンサー(CIS)・ディスプレイドライバ(DDIC)
- プロセス技術: 裏面照射型(BSI)CISプロセス、高耐圧CMOSプロセス。
- 用途: スマホ・車載カメラ、監視カメラ、有機EL(OLED)・液晶パネルの駆動用IC。
- RF(高周波)・IoT向け通信チップ
- プロセス技術:RF-CMOS、RF-SOI。
- 用途: Wi-Fi、Bluetooth、ミリ波レーダーなどの無線通信モジュール。
2. 先端ロジック領域(14nm〜7nm / 6nm級)
米国の輸出規制によりオランダASML製の最先端EUV(極端紫外線)露光装置を導入できない制約下で、既存のArF液浸(DUV)露光装置を用いた多重露光技術(SAQP:自己整合4重パターニングなど)を駆使して製造している領域です。
- AIアクセラレータ・サーバー向けGPU/NPU
- 製品例:ファーウェイ(HiSilicon)の「Ascend」シリーズや、寒武紀(Cambricon)などの中国国産AIチップ。データセンターでのAI推論・学習向けに需要が急増しています。
- スマートフォン向けハイエンドSoC・5Gモデム
- 製品例: ファーウェイの主力スマホに搭載される「Kirin」シリーズ(7nm世代のKirin 9000Sや、配線の微細化を進めた6nm級のKirin 9030など)。
- 汎用CPU・マイニング向けASIC
- 製品例: 飛騰(Phytium)や海光(Hygon)などの国産サーバー/PC向けCPU。
3. ウエハー口径ごとの役割分担
| ウエハー口径 | 対応プロセス世代 | 主な製造品目・用途 |
| 8インチ(200mm) | 90nm 〜 0.35μm(350nm) | パワー半導体(MOSFET)、アナログIC、指紋認証センサー、産業・車載用センサーなど多品種少量・特殊用途 |
| 12インチ(300mm) | 6nm級 / 7nm 〜 65nm | 先端AIチップ、スマホ用SoC、28nm/40nmのマイコン・OLEDドライバ・CISなどの大量生産品 |
TSMC(台湾)が2nm〜3nmの最先端プロセスで世界のAI・スマホ向けハイエンドチップを独占しているのに対し、SMICは「中国国内のあらゆる電子機器・EV・産業機器を動かすための基盤半導体(28nm以上)の自給自足」と「EUVなしでの国産AIチップ・スマホ用SoC(7nm級)の量産」という2つの役割を担っています。
SMICは顧客の設計通りに受託生産を行うファウンドリーです。家電やEV、産業機器向けの電源管理IC、マイコン、センサーなどの「成熟世代(28nm以上)」を主力としつつ、国産AIチップやスマホ用SoCなど「7nm級の先端半導体」まで幅広く製造しています。
なぜ純利益が増加したのか
SMICの2026年7〜9月期(第3四半期)において純利益が前年同期比で約2.2倍(+123.4%)の4億2,840万ドルへと急増した背景には、「需要の急増による売上拡大」と「粗利益率の大幅な改善」という2つの収益押し上げ要因があります。
1. 売上拡大の要因(トップラインの成長)
売上高は前年同期比33.9%増の31.9億ドルとなり、四半期として過去最高を更新しました。
- AI関連周辺チップの特需と世界的な供給逼迫
- AIサーバーの普及に伴い、電源管理用のBCD(バイポーラ・CMOS・DMOS)プロセス、専用メモリー、制御用チップ(Control)といった「AI周辺・成熟世代半導体」の引き合いが予想を大きく上回りました。世界のファウンドリー各社がAI向け最先端チップに生産能力を割いた結果、これら成熟世代の受託製造能力も世界的に極度に逼迫し、SMICへの受注が集中しました。
- 米中摩擦に伴う「国産代替(現地化)」の定着
- 米国の輸出規制リスクを回避するため、中国のファブレス(半導体設計)企業や車載・家電メーカーが海外ファウンドリーから中国国内へ生産委託先を切り替える動きが一段と進みました。
- ウエハー出荷枚数の記録的増加
- 上記の受注増により、8インチ換算のウエハー出荷枚数は前年同期比21.4%増の約303万枚に達し、四半期として初めて300万枚の大台を突破しました。
2. 利益率改善の要因(収益性の向上)
売上の伸び(+33.9%)以上に純利益(+123.4%)が大きく跳ね上がったのは、粗利益率が前四半期の25.3%から29.9%へと4.6ポイントも急上昇したためです。
- 97.3%という異例の「フル稼働」による固定費の吸収
- 半導体工場は減価償却費などの固定費負担が非常に大きいビジネスモデルですが、設備稼働率が97.3%まで上昇したことで、ウエハー1枚あたりの固定費負担が大幅に低下し、利益が急拡大するレバレッジが働きました。
- プロダクトミックス(製品構成)の高付加価値化
- 需給逼迫を背景に、利幅の大きいBCDプロセス製品や、需要が急拡大している産業・車載向け(売上比率19.3%へ上昇)など、比較的単価と利益率の高い製品の出荷比率が高まりました。
- 設備投資ペースの調整による減価償却負担の緩和
- 当四半期は新規の設備投資(CapEx)を前年同期比で約4割抑え、既存ラインの生産転換・最適化に重点を置いたことで、減価償却費の急増が抑えられた点も利益押し上げに寄与しています。
AI需要による世界的な半導体不足とAIアクセラレータなどでの国産化シフトで受注が急増し、過去最高の売上高を記録したためです。また、設備稼働率が97.3%のフル稼働に達して固定費負担が下がり、高採算製品の比率も高まったことで粗利益率が大きく改善しました。
AIアクセラレータとは何か
AIアクセラレータ(AI Accelerator)とは、ディープラーニング(深層学習)や機械学習における膨大な計算処理、特に大規模な行列演算やテンソル演算を高速かつ高効率に実行することに特化した専用プロセッサ(ハードウェア)の総称です。
AIモデルの学習(Training)や推論(Inference)のプロセスでは、何十億〜何兆というパラメータを持つニューラルネットワークの数理計算を同時に処理する必要があり、これを従来の汎用プロセッサで行うには限界があります。そのため、AIのワークロードに特化した専用アーキテクチャが必要とされます。
1. なぜAI専用のアクセラレータが必要なのか(CPUとの違い)
- CPU(中央処理ユニット):複雑な分岐処理や論理演算を少数のコアで高速にこなす「逐次処理」の得意な頭脳です。しかし、AIの学習で必要とされる膨大な数の単純な並列計算(行列のかけ算など)を実行しようとすると、バスの帯域やコア数がボトルネックとなり、処理速度が大幅に低下します。
- AIアクセラレータ:制御機能を最小限に抑え、数千から数万の演算器を並列配置することで、単純な数理計算を圧倒的なスピードで同時に処理します。
2. 主要なアーキテクチャと内部メカニズム
AIアクセラレータが高性能を達成するための代表的なエンジニアリング手法には、以下のようなものがあります。
- 膨大なMAC(積和演算)アレイ
- AI計算の基本である「乗算(Multiply)と加算(Accumulate)」を同時に行うMACユニットを、グリッド状に数千〜数万個敷き詰めています。これにより、1クロックサイクルあたりに処理できる行列演算の密度を極限まで高めています。
- 高帯域幅メモリ(HBM)による「メモリ壁」の突破
- 計算速度がいくら速くても、メモリからデータを読み書きする速度が追いつかなければプロセッサは遊んでしまいます(フォン・ノイマン・ボトルネック)。
- AIアクセラレータは、シリコン貫通電極(TSV)技術を用いてDRAMダイを垂直に積層したHBM(High Bandwidth Memory)をプロセッサと密着配置し、超広帯域(テラバイト級/秒)のデータ転送を実現しています。
- 低精度演算(Quantization)のハードウェア最適化
- 従来の科学技術計算で使われる64ビット(FP64)や32ビット(FP32)の浮動小数点数だけでなく、AIの精度をほとんど落とさずに表現できる16ビット(FP16/BF16)、8ビット(FP8/INT8)といった低精度フォーマットをハードウェアレベルでネイティブにサポートします。ビット数を下げることで、消費電力を抑えつつ計算のスループットを飛躍的に向上させています。
3. 主な種類と代表例
用途やアーキテクチャの設計思想によって、いくつかの形態に分かれます。
- GPU(グラフィックス処理ユニット):元々は3D描画用の並列計算チップでしたが、その並列処理能力がAIの行列演算に極めて適していることが判明し、現在のAIアクセラレータの主流となっています(例:NVIDIAのTensor Core搭載GPUなど)。
- ASIC(特定用途向け集積回路):AIの計算アルゴリズム専用に回路を焼き込んだもので、汎用性を犠牲にする代わりに圧倒的な電力効率と処理速度を誇ります(例:GoogleのTPU、ファーウェイの「Ascend」シリーズなど)。
- FPGA(フィールド・プログラマブル・ゲート・アレイ):製造後に出荷者が回路を書き換えられるチップ。AIアルゴリズムの変更やエッジデバイス(IoT機器など)でのリアルタイム推論に多用されます。
AIアクセラレータは、ディープラーニングなどの膨大な行列・並列演算を高速処理する専用プロセッサです。CPUが苦手とする複雑な数理計算を数千のコアで同時に実行し、AIの学習や推論を効率化します。
コメント