この記事で分かること
アリババの真武V900早期投入
中国アリババ集団(Alibaba Group)が、自社開発を進める次世代AI向け半導体(AIアクセラレータ)真武V900の投入時期を当初の予定から約半年前倒しする動きを見せています。
中国国内での大規模言語モデル(LLM)開発競争が加速しており、5兆〜10兆パラメータークラスの超巨大モデルの学習・推論を支える計算基盤の確保が急務となっています。
中国市場での急速なAIインフラ需要の高まりと、米国の対中半導体規制に伴う供給課題に対応する狙いがあります。
真武V900はどんな半導体なのか
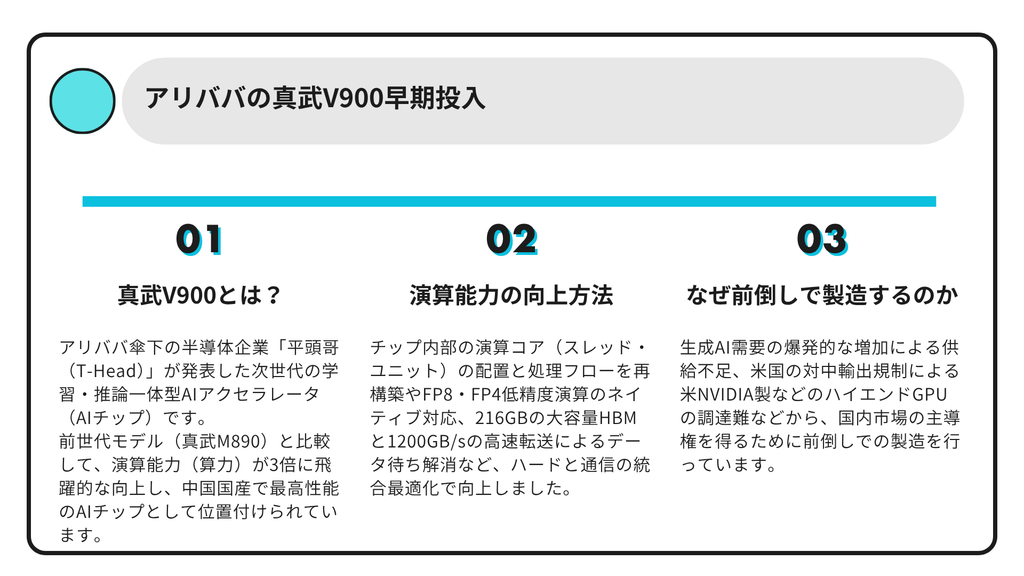
真武V900(Zhenwu V900)は、アリババ傘下の半導体企業「平頭哥(T-Head)」が発表した次世代の学習・推論一体型AIアクセラレータ(AIチップ)です。「中国国産で最高性能のAIチップ」として位置付けられています。
主な特徴とスペック
- 演算性能が従来比3倍
前世代モデル(真武M890)と比較して、演算能力(算力)が3倍に飛躍的な向上を果たしています。 - 216GBの大容量メモリ(VRAM)搭載
単一チップで216GBの大容量メモリを搭載しており、巨大なパラメーターを持つ大規模言語モデル(LLM)のデータを直接高速処理できます。 - 超高速インターコネクト(1200GB/s)
チップ同士を結ぶ相互接続帯域幅は1200GB/sに達し、複数枚のチップを連携させた際のデータ転送ボトルネックを最小限に抑えています。 - FP8・FP4低精度計算をネイティブサポート
生成AIの高速化・省電力化に有効なFP8やFP4といった低精度演算フォーマットに対応し、計算密度を高めています。 - 最大50万カード規模の巨大クラスタに対応
単一クラスタで最大50万枚のチップを連結・並列稼働させることが可能で、数兆〜10兆パラメーター級の超巨大AIモデルの学習・推論インフラを支えます。
位置付けと狙い
米国の輸出規制により米NVIDIA製のハイエンドGPU(H100やBlackwellシリーズなど)の調達が難しい中、アリババクラウドの計算基盤や自社AI「通義千問(Qwen)」の学習・運用を国産ハードウェアで代替し、自給率と競争力を高めるためのフラッグシップチップとなっています。
アリババ傘下の平頭哥が開発したAIプロセッサです。従来比3倍の演算力、216GBの大容量メモリ、1200GB/sの高速転送を備え、最大50万枚規模のクラスタで大規模AIの学習・推論に対応します。
どのように演算能力を向上したのか
真武V900は、自社開発アーキテクチャの刷新、低精度演算のネイティブ対応、そしてメモリ・通信ボトルネックの解消というハード・ソフト両面からの統合的アプローチによって前世代比3倍の演算能力を実現しています。
1. 独自並列計算アーキテクチャの刷新
- 平頭哥(T-Head)が新規設計した自社開発の並列計算アーキテクチャを採用しています。
- チップ内部の演算コア(スレッド・ユニット)の配置と処理フローを再構築し、単位面積あたりの演算密度とコアの稼働効率を大幅に引き上げました。
2. FP8・FP4低精度演算のネイティブサポート
- 生成AI(LLM)の高速処理に有効なFP8(8ビット浮動小数点)およびFP4(4ビット浮動小数点)の低精度演算をハードウェアレベルでネイティブサポートしています。
- 精度を保ちつつデータサイズを小さくして並列演算を行うことで、単位時間あたりの計算スループットを劇的に高め、実効パフォーマンスと推論効率を向上させています。
3. 「メモリーの壁」と通信遅延の解消
- 216GBの大容量高帯域幅メモリ(HBM)と1200GB/sのチップ間相互接続帯域幅を搭載しています。
- 演算コアに対してデータを供給する速度や、チップ間でデータをやり取りする通信が追いつかない「メモリーの壁(Memory Wall)」やデータ転送待ちを排除し、演算器の稼働率(アロケーション効率)を常に高い状態で維持しています。
4. 超大規模クラスタでの高いスケーリング効率
- 最大50万枚規模のチップを連結できるクラスタ設計を備えており、複数チップ間での並列処理ロス(通信オーバーヘッド)を最小限に抑えています。
- 単体チップの能力強化だけでなく、大規模システム全体として計算力がリニア(線形)に拡大するよう統合的に最適化されています。
独自アーキテクチャによるコア効率化、FP8・FP4低精度演算のネイティブ対応、216GBの大容量HBMと1200GB/sの高速転送によるデータ待ち解消など、ハードと通信の統合最適化で向上しました
なぜ前倒しで製造するのか
アリババ集団が次世代AI半導体「真武V900」などの投入・製造を半年前倒しした主な理由は、需要の急増、米国の規制リスク、そして市場での競合優位性の確保という3つの緊急要因が重なったためです。
1. 生成AI需要の爆発的な増加(供給不足の解消)
- 数兆〜10兆パラメーター級の超巨大AIモデル(自社の「通義千問/Qwen」や顧客企業の大規模モデル)の学習・推論需要が予想を上回るペースで急増しています。
- アリババクラウドのインフラ拡張ペースを早め、計算資源(算力)の深刻な不足を回避するために製造スケジュールを繰り上げる必要がありました。
2. 米国の対中輸出規制への対応(国産化の急務)
- 米国政府による先端半導体の輸出規制が厳格化・長期化し、米NVIDIA製などのハイエンドGPUの調達が極めて難しくなっています。
- 海外製チップに依存し続けるリスクを排除し、自社および国内顧客のAI開発を止容させないため、自社開発の「国産代替チップ」の供給確立を一刻も早く達成する必要がありました。
3. 国内クラウド・AI市場での主導権争い
- ファーウェイ(Huawei)や百度(Baidu)など、中国国内のIT大手も独自のAIチップ開発とクラウド基盤の構築を急速に進めています。
- 半年前倒しで投入することで、アリババクラウドを利用する企業に対して安価で高性能な計算資源を先んじて提供し、顧客の囲い込みとシェア獲得を図る狙いがあります。
4. 設計・開発プロセスの順調な進捗
傘下の半導体企業「平頭哥(T-Head)」によるアーキテクチャ最適化やテストプロセスが予定よりもスムーズに進み、量産化・実用化の技術的目処が早期に立ったことも前倒しを後押ししました。
米国の対中規制で海外製GPUの調達が困難になる中、急増する生成AI需要に迅速に対応し、国内市場の主導権を得るためです。開発の順調な進捗により、国産代替チップの量産・供給の前倒しが可能となりました。
コメント