この記事で分かること
ファーウェイのτの法則による半導体設計
ファーウェイ(Huawei)が新スマートフォンに独自の半導体設計理論「タウ(τ)の法則」を採用ことが報じられています。
タウ(τ)の法則は、米国の制約下で最先端のEUV(極端紫外線)露光装置が入手困難な状況において、同社が打ち出した新たな打破策であり、半導体の進化における大きな転換点として注目を集めています。
τの法則とは何か
「タウ(τ)の法則」とは、半導体の性能向上において「トランジスタの物理的微細化」ではなく「信号の伝送遅延(τ)の極小化」を最優先指標とする、ファーウェイ(Huawei)提唱の新世代半導体設計理論です。
1. 理論の根幹:時間定数「τ」の極小化
電気回路において、ギリシャ文字のτ(タウ)は信号が伝わるときにかかる「時間定数(RC遅延)」を表します。
τ = R × C
- R(抵抗:Resistance): 配線の細さや長さによって生じる電気の抵抗
- C(静電容量:Capacitance): 絶縁層や隣接配線間に蓄えられる電荷
回路の微細化(5nm、3nmなど)が進むにつれ、トランジスタ自体のスイッチング速度よりも、細く長くなった配線を通るデータの遅延(RC遅延 =τ)がチップ全体の性能を阻害する「ボトルの首」になっていました。タウの法則は、この τ(タイムラグ)を物理的・論理的に削り込むことに特化したアプローチです。
2. 「タウの法則」を支える3つの柱
- LogicFolding(3Dロジック折りたたみ構造)平面的(2D)に広がっていた論理回路を、オリガミのように立体的に折りたたんで重ね合わせます。マイクロメートル単位の直接接合(ハイブリッドボンディング)で垂直に繋ぐことで、平面上では長かった配線距離を数百分の1に短縮し、τ(遅延時間)を大幅に減らします。
- ヘテロジニアス(異種機能)統合演算を行うCPU/GPU、思考を担うNPU、データを保持するSRAM/DRAMなどの異種ブロックを、基板レベルではなくチップ内部で近接・立体配置します。チップ間をまたぐデータ移動のタイムラグをゼロに近づけます。
- 時空間(Spatiotemporal)回路最適化信号が届くまでの「時間差」をクロック単位で再計算し、データが同時に目的地に届くよう回路の幾何学的配置をミリ単位で最適化します。
3. 「ムーアの法則」との違い
| 項目 | ムーアの法則(従来の常識) | タウの法則(新アプローチ) |
| 評価軸 | トランジスタ密度・回路線幅(nm) | 信号伝送遅延時間(τ / レイテンシー) |
| 性能向上手段 | EUV露光装置による2D平面の微細化 | 3D積層・LogicFoldingによる配線短縮 |
| 依存要素 | 最先端の露光装置・製造プロセス | パッケージング技術・立体回路設計思想 |
| ボトルネック | 物理的限界(量子漏れ電流、露光装置入手) | 発熱密度(放熱対策)、3D接合の製造歩留まり |
4. 開発の背景と技術的意義
米国による貿易制約のもと、先端EUV露光装置の購入が困難なファーウェイが、「製造装置に頼る平面微細化」から「立体設計による構造改革」へシフトした結果生まれた打破策です。
既存の露光技術(DUVなど)で製造したチップであっても、τ(遅延)を徹底的に削ることで、ワン世代〜ツー世代先の微細プロセスに匹敵する実効速度とエネルギー効率(W当たりの処理能力)を引き出すことを可能にしています。
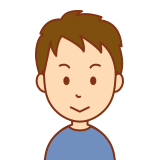
τの法則とは、ファーウェイが提唱する半導体設計理論です。回路の物理的微細化に頼らず、立体積層(3D)などで配線長を短縮し「信号伝送遅延(τ)」の極小化を最優先することで、性能と省電力を大幅に高めます。
どのようにLogicFoldingを実現するのか
「LogicFolding(3D論理折りたたみ)」の実現は、単に「複数のチップを上に積み重ねる(パッケージング)」のではなく、「チップ内部の回路配線そのものを立体的に組み替える」という設計・製造プロセスの根本的な転換によって達成されています。
その具体的な実現メカニズムは、以下の4つの要素技術で構成されています。
1. サブ2ミクロン級「超微細ハイブリッドボンディング」
LogicFoldingを支える最も重要な製造技術が、ウエハやチップ同士を直接接合するハイブリッドボンディングです。
- 従来の限界を突破: これまでの3D積層(TSVやマイクロバンプ)は接合ピッチが10〜40μm程度と大きく、大容量キャッシュメモリなどの限定的な配置にしか使えませんでした。
- 金属配線レベルの垂直結合: ファーウェイはこれを1.5〜1.0μm(将来的には720nm)まで超微細化。上層と下層の銅(Cu)電極と絶縁膜を原子レベルで直接接着させることで、100mm2あたり数億本もの垂直配線を実現し、3D接続を「チップ内部の金属配線」と同等レベルまで高密度化しています。
2. ウエハレベル超高精密アライメント&平坦化(CMP)
超微細なピッチで積層を成功させるため、製造プロセスには露光装置並みの精度が要求されます。
- 原子レベルの平坦化(CMP):接合面の凹凸を0.3nm(原子数個分)以下まで研磨。
- ナノレベルの位置合わせ(アライメント):2枚のウエハを100nm以下の精度で高精度に重ね合わせます。
- 低温アニール(熱処理): 200〜250℃程度の低温で加熱し、銅原子を界面で拡散・融合させて完全な電気的接続を形成します。
3. 3D論理分割(Logic Partitioning)と新EDAツール
従来の半導体設計(EDAツール)は2D平面を前提としていましたが、LogicFoldingでは幾何学的・時間軸を考慮した3D自動配置配線を行います。
- 平面回路の立体切断: 信号のやり取り頻度が高い論理ゲート(Logic Gate)同士を直上・直下に配置するよう回路を分割。
- 信号のタイムラグ(τ)同時最適化: 3D空間全体でクロック信号が同時に届くよう配線経路を再計算し、平面的には遠かったブロック間の配線長を数百分の1に圧縮します。
4. 充放電電力の削減による「発熱問題」の克服
「3D構造にすると熱がこもる」という懸念に対し、LogicFoldingは配線静電容量(C)の低減による発熱の抑制で解決を図っています。
半導体の動的消費電力は P = C× V2 × f(C: 静電容量、V: 電圧、f: 周波数)で表されます。長い横配線を短い垂直配線に変えることで、信号線の充電・放電に使われるエネルギー(配線容量 C)が劇的に減少します。
その結果、充放電由来の発熱が最大60%以上抑制され、高密度に折りたたんでも動作可能な熱設計が成立します。
従来技術との比較
| 項目 | 従来の3D積層(例: 3D V-Cacheなど) | LogicFolding(タウの法則) |
| 主な対象 | ロジック + メモリ(SRAM/DRAM) | ロジック + ロジック(演算回路の直接折りたたみに対応) |
| 接続ピッチ | 9〜40μm 程度(マイクロバンプ / TSV) | 1.5〜0.72μm(ダイレクトハイブリッドボンディング) |
| 接続の役割 | チップ間・ブロック間のデータ伝送 | 回路内部の論理ゲート間配線そのもの |
| 設計思想 | 面積の拡張・大容量化 | 信号遅延時間(τ)と配線電力の削り込み |
この「製造装置(EUV露光機)に頼らず、超微細積層と3D回路設計で配線長を詰める」アプローチこそが、LogicFoldingの実装における核心です。
LogicFoldingは、超微細ハイブリッドボンディング技術で実現します。回路同士を1ミクロン級の垂直配線で高密度に直接結合し、平面回路を立体的に重ね合わせることで、配線距離と遅延を劇的に短縮します。
スマートフォンへの適用時の性能への影響
「タウの法則」および「LogicFolding」をスマートフォンに適用した場合、実使用感・設計・パフォーマンスの面で主に4つの大きな効果が得られます。
1. 処理速度とレスポンスの向上(実効性能の底上げ)
- アプリ起動・画面遷移の高速化: データを遠くまで運ぶ必要がなくなるため、CPU/GPUやNPU(AIエンジン)間の通信遅延(レイテンシー)が激減し、操作のサクサク感が増します。
- 高負荷な処理の円滑化: 画像処理(オンデバイスAI)や3Dゲーム描写において、クロック周波数だけでは得られない「命令の待ち時間削減」による高フレームレートの維持が可能です。
2. 電力効率の向上と「バッテリー持ち」の改善
- 配線充放電電力のカット: 半導体内で電力を多く消費する「長い横配線の充放電」が不要になり、主要CPUコアのエネルギー効率が約40%以上向上します。
- 長時間駆動: 同じバッテリー容量であっても、動画再生・ゲーム・AI処理時などの消費電力を大幅に抑えられます。
3. チップの小面積化と「端末内部スペース」の確保
- 設置面積(フットプリント)の縮小: 2D平面で広がっていた回路を立体に折りたたむことで、メイン基板上に占めるチップの平面積を大幅に小さくできます。
- バッテリー増量・冷却強化へ還元: チップが小さくなった分のスペースを、より大きなバッテリーの搭載や冷却システム(ベイパーチャンバー等)の強化に配分できます。
4. 制限下での「フラッグシップ級体験」の実現
- 旧世代製造技術の克服: 最先端のEUV露光装置(3nm/2nmプロセスなど)を使えなくとも、設計とパッケージングで補うことで、競合他社の最先端フラッグシップスマホと同等レベルのパフォーマンスを届けることができます。
「発熱とバッテリー消費を抑えながら、アプリのレスポンスやAI処理を最先端スマホ並みに速くし、本体の設計自由度を高められる」 というのが、スマートフォンに適用した際の実質的な効果です。
スマホに適用すると、遅延短縮によりAIやアプリが高速化します。また、配線電力の削減で大幅な省電力・バッテリー長持ちを実現。さらにチップの平面積が減り、バッテリー増量など内部設計の自由度も高まります。
コメント